一、一个正在发生的变化:AI开始“看”视频和图片了
1.1 你的视频,AI可能根本不知道它讲了什么
企业在视频和图片上的投入越来越大——产品介绍视频、案例展示、门店实拍、短视频营销。但这些内容有一个共同的问题:AI看不懂。
传统SEO优化的是文本,爬虫读HTML文字就能索引。但视频内容“锁在”音视频流里,AI引擎无法直接理解视频本身。一张产品图片如果没有Alt标签和结构化标注,AI同样无法识别图片中是什么产品、什么品牌。
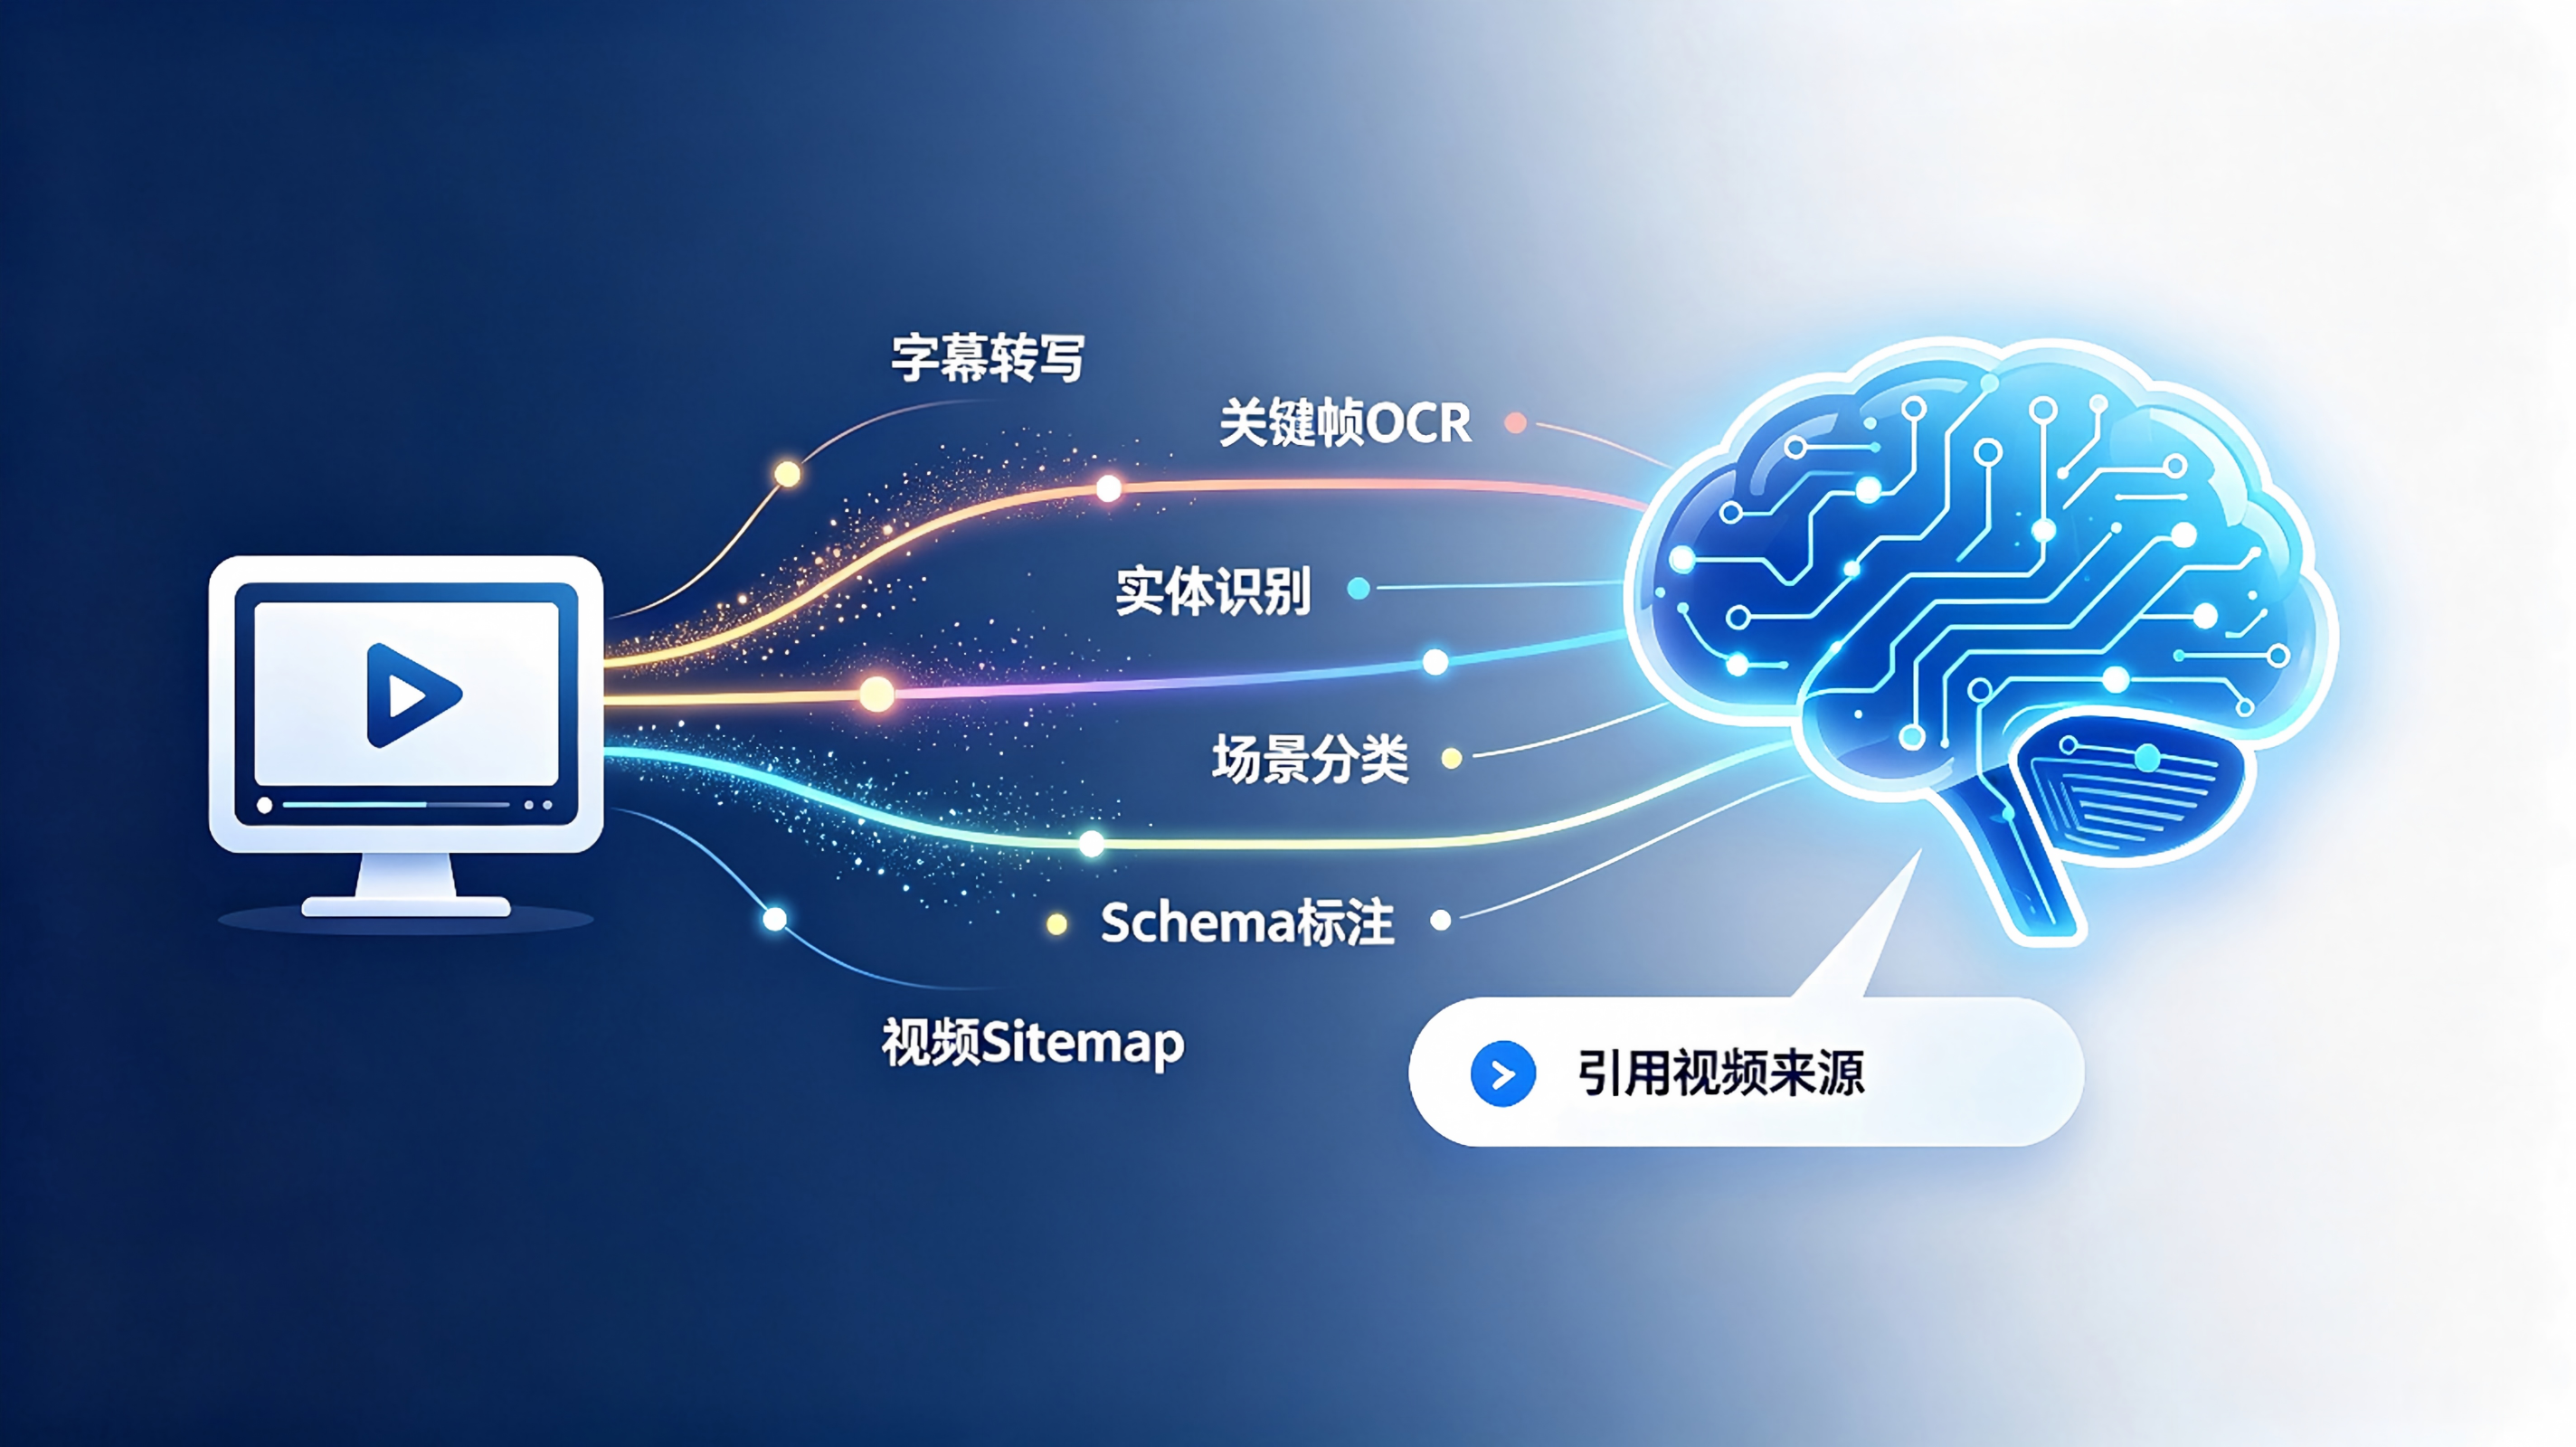
一个典型的场景:用户问AI“XX品牌的XX产品怎么样”,如果该品牌有一段详细的产品测评视频,但没有做多模态优化,AI根本不知道这个视频讲了什么,自然不会引用。做了多模态优化后,AI可以从字幕、关键帧、OCR、实体标注、场景分类、Schema结构化数据等多个信号验证内容,优先引用。
1.2 多模态内容的引用权重正在快速上升
行业数据显示,多模态内容在AI生成答案块中的引用占比已达35%至50%,且随着视频、AR等非文本内容语义蒸馏技术的成熟,业界预测该权重将提升至50%以上。
“多模态引用将在12个月内成为标配。图片、视频、图表会自然地嵌入AI回答中,成为标准配置。这对内容创作者提出了新要求——内容的多模态丰富度成为GEO的一个全新维度”。
对企业的含义很直接:如果你的视频和图片没有被AI“读懂”,你就在AI答案中主动放弃了一半以上的被引用机会。
二、多模态GEO和传统视频SEO到底有什么区别?
很多企业会把多模态GEO和视频SEO混为一谈。两者有本质区别:
| 维度 | 传统视频SEO | 多模态GEO |
|---|---|---|
| 服务对象 | 搜索引擎爬虫 | AI生成式引擎(豆包、DeepSeek等) |
| 优化目标 | 视频在搜索结果中排名靠前 | 视频内容被AI理解并引用 |
| 检索方式 | 标题、描述、标签关键词匹配 | RAG语义检索+多信号交叉验证 |
| 内容形态 | 文本元数据为主 | 视频/图像/音频多模态协同 |
| 证据要求 | 单一路径即可(标题匹配) | 多条路径互相佐证 |
| 衡量指标 | 播放量、排名位置 | AI引用率、品牌提及率 |
核心差异:视频SEO追求的是“用户搜关键词时能看到你的视频标题”,多模态GEO追求的是“用户向AI提问时,AI能准确理解你的视频内容并引用其中信息”。
三、视频的多模态GEO:六条检索路径
把一个视频拆解成AI能“读”的六条检索路径,是多模态GEO的核心方法。
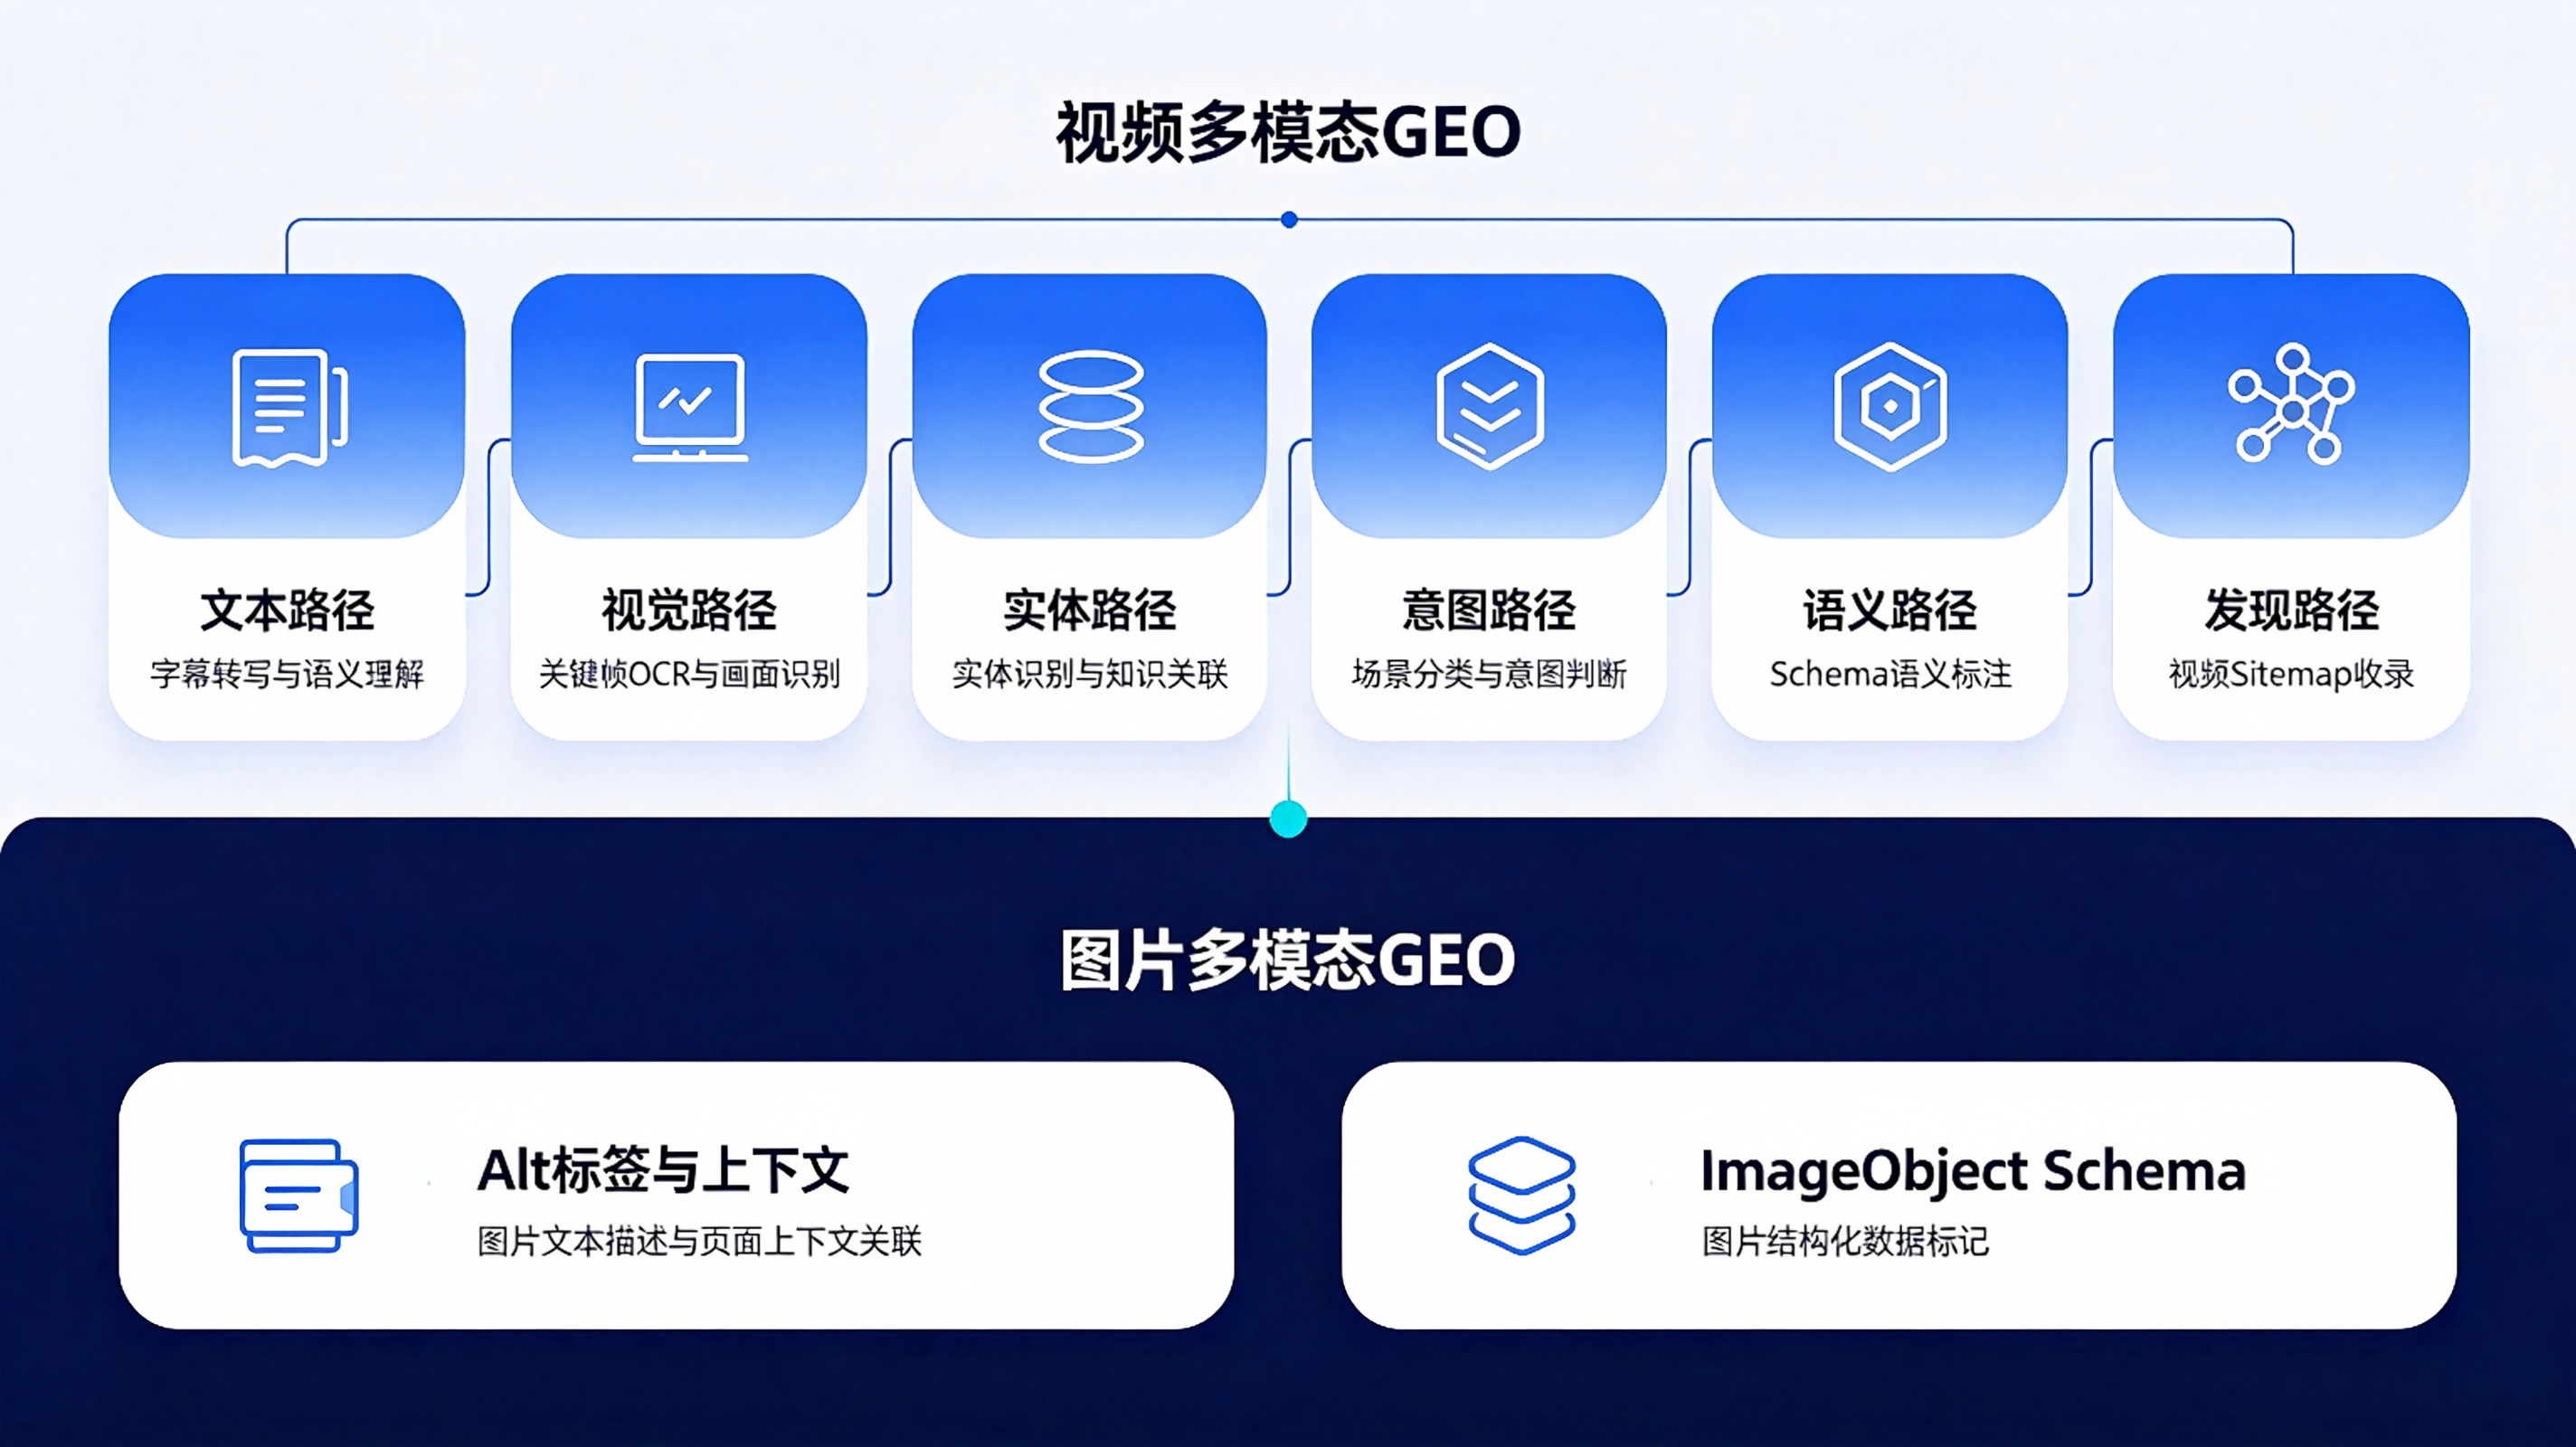
路径一:文本路径——把语音转成AI能读的文字
AI首先需要“读”到视频的内容。做法是将视频中的语音转写为结构化字幕文件。
具体操作:
使用Whisper等ASR工具将视频语音转写为文本
清洗填充词(“嗯”“那个”等口语化表达)
输出SRT和WebVTT双格式字幕文件
在WebVTT中使用说话人标注标签(如<v 主持人>),帮助AI识别对话结构
关键认知:字幕不只是给人看的,更是给AI读的。没有字幕的视频,在AI眼中就是“无声的默片”。
路径二:视觉路径——让AI“看懂”画面内容
视频画面中有大量关键信息:产品名称、价格标注、参数表格、品牌Logo。这些信息需要通过关键帧提取和OCR来捕获。
具体操作:
对视频进行场景检测,智能抽取关键帧
用AI视觉模型描述画面内容
用OCR提取画面中的文字信息(产品名、价格、字幕条)
将提取的视觉信息与文本路径的内容合并
关键价值:OCR能捕获音轨无法获取的视觉实体,比如屏幕上显示的产品参数表、价格标签、品牌标识。
路径三:实体路径——让AI建立知识图谱关联
AI理解内容的方式是“实体关联”。视频中的人物、品牌、产品、地点,需要被识别为明确的实体,并与品牌知识图谱建立关联。
具体操作:
视觉实体识别:用AI识别画面中的人物、品牌Logo、产品外观
音频实体提取:用正则表达式从字幕中提取品牌名、地点、价格
跨模态合并去重:将视觉和音频识别的实体合并,避免重复
将实体标注关联到品牌知识图谱节点
关键价值:实体标注让视频内容与品牌知识图谱关联,帮助AI在回答“XX品牌有什么产品”时,能够从视频中调取相关信息。
路径四:意图路径——让AI在对的场景找到你
用户提问的意图不同,AI优先匹配的视频类型也不同。视频需要被分类,以便AI在正确场景下调用。
具体操作:
将视频按意图分类:教程/评测/演示/采访/广告/Vlog/其他
用户问“怎么用”→教程类视频优先
用户问“怎么样”→评测类视频优先
用户问“好不好”→用户评价类视频优先
关键价值:场景分类让视频在正确的用户意图下被AI优先匹配,而不是被“错配”到不相关的问题中。
路径五:语义路径——用Schema结构化数据标注视频
VideoObject JSON-LD是最重要的技术部署之一。它相当于给视频提供一份标准化的“说明书”。
必须标注的字段:
about:视频主题(如“全屋定制安装流程”)
mentions:视频中提及的品牌、产品、人物
genre:视频类型(教程/评测/演示等)
hasPart:视频章节片段
caption和subtitle:字幕文件链接
关键价值:about和mentions字段让AI直接获取视频主题和涉及实体,不需要从零解析视频内容。
路径六:发现路径——让AI爬虫找到你的视频
视频再优化,如果AI爬虫找不到,一切归零。
具体操作:
创建XML视频Sitemap
确保视频页面有稳定的URL,避免动态参数
在视频页面嵌入结构化数据,标注视频与页面的关联
确保视频页面本身是AI可抓取的(不要纯JS渲染)
四、图片的多模态GEO:两条核心路径
相比视频,图片的多模态优化更简单,但同样关键。
路径一:Alt标签与上下文——让AI“读”懂图片
Alt标签是图片最基础的语义标注。但大多数企业只填了“产品图片1”这类无意义描述。
GEO友好的Alt标签写法:包含品牌名+产品名+核心特征+使用场景。
❌ 错误:“产品图.jpg”
✅ 正确:“汉梵数科GEO优化四层递进模型示意图”
图片周围的上下文同样重要。图片上方的标题、下方的图注、前后段落的文字,都会帮助AI理解图片的语义。
路径二:图片Schema——让AI“结构化”理解图片
对于产品图、流程图、数据图等关键图片,建议部署ImageObject Schema。
关键字段:
contentUrl:图片文件地址
description:图片内容描述
caption:图注文字
about:图片主题实体
representativeOfPage:是否代表页面核心内容
五、天津企业的多模态GEO落地场景
场景一:本地门店——门店实拍视频和图片是AI本地推荐的关键证据
天津的连锁餐饮、家居建材、婚礼策划等本地服务企业,门店实拍视频和图片是最容易被AI在“本地推荐”类问题中引用的内容。
具体操作:
为每家门店拍摄1-2分钟的实景视频,包含门店外观、内部环境、核心服务展示
视频添加字幕,转写文字内容
用VideoObject Schema标注视频,about字段写明“天津XX区XX门店环境展示”
门店图片添加包含品牌名+区域+场景的Alt标签
场景二:B2B工业制造——产品演示视频是AI判断专业度的关键依据
天津的工业制造和B2B企业,产品演示视频、工厂实拍、技术讲解视频是AI在回答“XX设备怎么样”“XX供应商靠谱吗”时优先引用的内容。
具体操作:
将产品演示视频转写为带时间戳的字幕
用OCR提取视频画面中的产品参数、技术指标
VideoObject Schema标注视频的about(产品型号+应用场景)和mentions(品牌名+产品名)
在视频页面嵌入FAQ结构化数据,将视频内容拆解为可独立引用的问答单元
场景三:专业服务——案例视频和客户证言是AI建立信任的关键素材
天津的留学教育、法律咨询、财税服务等专业服务企业,案例复盘视频和客户证言视频是AI在回答“XX机构怎么样”时的重要引用来源。
具体操作:
案例视频添加结构化字幕,标注客户背景、服务过程、成果数据
在视频Schema中标注about为“XX行业XX服务案例”
将视频关键帧截图作为图片素材,添加结构化Alt标签
六、多模态GEO的执行路线图
| 阶段 | 时间 | 核心任务 |
|---|---|---|
| 第一阶段:基础建设 | 第1-2周 | 为现有视频添加字幕转写;为图片添加结构化Alt标签 |
| 第二阶段:技术部署 | 第3-4周 | 部署VideoObject和ImageObject Schema;创建视频Sitemap |
| 第三阶段:内容优化 | 第2-3月 | 按意图分类重新组织视频内容;补充关键帧OCR提取 |
| 第四阶段:监测迭代 | 持续 | 每月测试AI引用变化,优化未被引用的内容 |
FAQ
Q1:多模态GEO和传统的视频SEO有什么区别?
视频SEO优化的是“视频在搜索结果中的排名”,多模态GEO优化的是“视频内容被AI理解和引用”。前者依赖标题、标签的关键词匹配,后者依赖字幕、OCR、实体标注、Schema等多信号交叉验证。
Q2:没有专业视频团队的小企业怎么做?
从最基础的两步开始:① 给现有视频添加字幕转写(可用免费工具);② 给产品图片和门店图片添加包含品牌名+场景的Alt标签。这两步零成本,但能让AI开始“读懂”你的内容。
Q3:多模态GEO多久能看到效果?
字幕和Schema部署完成后,通常2-4周内可见AI引用变化。但多模态内容的引用权重提升需要持续积累,建议以季度为单位评估整体效果。
Q4:视频和图片的优化,哪个优先级更高?
建议视频优先。视频的引用权重更高,且能承载更丰富的信息(产品演示、技术讲解、案例复盘)。如果视频制作能力有限,先从图片的结构化Alt标签和Schema标注做起。